

Информационные капсулы в SEO: структура контента под умные алгоритмы
За последние несколько лет поисковый ландшафт претерпел фундаментальную трансформацию. Эпоха, когда для вывода страницы в ТОП-10 Яндекса и Google было достаточно насытить текст ключевыми фразами и соблюсти формальный объем знаков, окончательно ушла в прошлое. Внедрение нейросетевых языковых моделей (Yandex Y1/Y2, Google RankBrain, BERT и MUM) научило алгоритмы оценивать не просто совпадение слов, а глубину раскрытия темы, логическую связность и реальную полезность материала для пользователя.
Сегодня поисковые роботы анализируют контент на уровне микросмыслов и информационных узлов. Как отмечают ведущие эксперты seo-akademiya.by, ключевым трендом контент-маркетинга стал переход от абстрактных статей к жестко структурированным экспертным материалам с модульной архитектурой капсульных ответов. Такие материалы способны не только удерживать лидерство в традиционной поисковой выдаче, но и напрямую цитироваться генеративными блоками поисковых систем (AI Overviews, умные сниппеты, чат-боты).
Чтобы корпоративный блог или информационный раздел коммерческого сайта приносил целевые лиды и устойчивый органический трафик, создание контента должно опираться на инженерный подход к структурированию информации.
1. Кризис «водянистого» SEO: почему алгоритмы отсекают поверхностный рерайт
На протяжении десятилетия базовой стратегией создания статей был массовый заказ текстов у биржевых копирайтеров. Подрядчик брал первые три ссылки из выдачи, переписывал их синонимами, добавлял вводные слова («ни для кого не секрет», «в современном мире») и сдавал материал с формальной уникальностью 95%. Однако сегодня этот подход не просто бесполезен, но и токсичен для домена.
Современные поисковые краулеры обучены выявлять информационную ценность (Information Gain Score):
- Штраф за смысловую избыточность: если страница не содержит новых фактов, оригинальных данных или уникального опыта относительно уже существующих документов в базе, поисковик понижает ее приоритет в ранжировании;
- Метрики пользовательского удовлетворения (Task Completion Rate): если читатель открывает публикацию, видит общие рассуждения и не находит ответа в первом же экране, он возвращается в выдачу. Такой возврат (pogo-sticking) служит для алгоритма однозначным сигналом низкого качества;
- Фильтрация сгенерированного спама: миллионы низкокачественных статей, созданных базовыми промптами нейросетей без фактчекинга и редактуры, попадают под жесткие спам-фильтры (Google Helpful Content System, антиспам-алгоритмы Яндекса).
Чтобы выделиться в условиях алгоритмической фильтрации, статья обязана обладать высокой плотностью проверенной информации и продуманной архитектурой подачи.
2. Концепция информационных капсул: самодостаточные смысловые блоки
Главный вызов современного веб-чтения — клиповое восприятие и катастрофический дефицит времени у пользователей. Посетитель сайта крайне редко читает 15 000 знаков от начала до конца. Вместо этого он сканирует страницу по диагонали (F-образный паттерн движения взгляда), выискивая решение своей узкой проблемы.
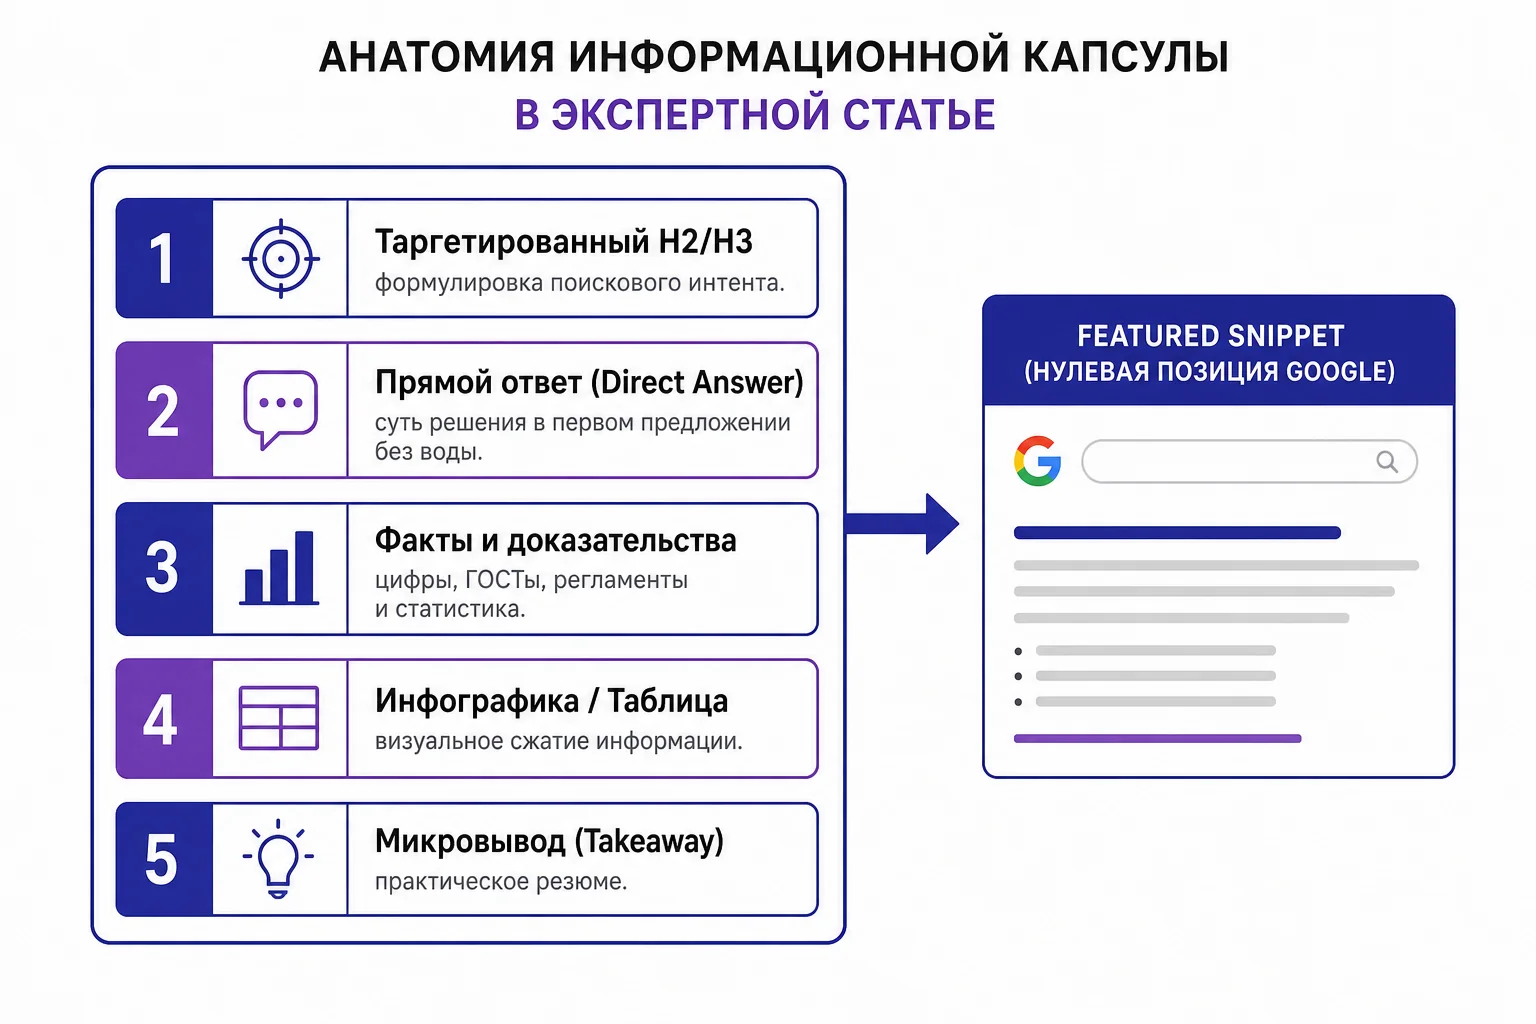
Решением этой проблемы выступает принцип «информационной капсулы» (Capsule Content Unit). Капсула — это автономный смысловой блок внутри статьи, построенный по следующему правилу:
- Четкий таргетированный подзаголовок: формулирует проблему на языке поискового запроса пользователя;
- Прямой ответ в первом предложении (Direct Answer): без вступительных оборотов формулируется суть решения (правило перевернутой пирамиды);
- Аргументация и доказательная база: конкретные цифры, отраслевые стандарты, ссылки на регламенты или практический опыт;
- Визуальное подкрепление: таблица, пошаговый нумерованный алгоритм или схема;
- Микровывод (Takeaway): 1–2 предложения с резюме, готовым к применению.
Такая модульность делает материал удобным как для человека, так и для поискового робота: краулер легко извлекает капсулу в расширенный сниппет (Featured Snippet) на нулевую позицию выдачи.
3. Иерархия подзаголовков и логика навигации лонгрида
Правильная иерархическая структура — это скелет статьи. Поисковые краулеры используют древовидную модель тегов для понимания связей между сущностями и темами.
При проектировании структуры экспертного материала соблюдаются строгие правила:
- Единственный главный заголовок H1: исчерпывающе описывает суть документа, содержит базовый кластерообразующий маркер и не дублирует поисковый метатег Title дословно;
- Крупные смысловые вехи H2 (8–10 разделов): каждый подзаголовок второго уровня открывает самостоятельный тематический кластер. Он должен читаться как осмысленный тезис, а не абстрактное слово («Подготовка», «Реализация»);
- Уточняющие секции H3: детализируют конкретные сценарии, инструменты или инструкции внутри раздела H2;
- Интерактивное оглавление (Table of Contents): блок с якорными ссылками на все разделы H2 в начале лонгрида. Это не только улучшает поведенческие факторы читателей, но и формирует быстрые ссылки (sitelinks) в сниппете поисковой выдачи.
4. Факторы E-E-A-T: внедрение маркеров экспертности и первоисточника
Критерии оценки качества Google (Experience, Expertise, Authoritativeness, Trustworthiness) и метрики экспертности Яндекса (пробирка Pro в выдаче, оценка авторства) требуют физического присутствия атрибутов доверия непосредственно на странице публикации.
Для подтверждения E-E-A-T в структуру экспертной статьи интегрируются следующие элементы:
- Именной авторский профиль: блок автора с фотографией, должностью, подтвержденным стажем в отрасли и ссылками на профильные публикации;
- Отметка о рецензировании (Fact-checked): подтверждение проверки материала практикующим техническим или отраслевым специалистом;
- Прямые ссылки на первоисточники: цитирование нормативно-правовых актов, официальных регламентов, профильных ГОСТов и первичных статистических исследований;
- Реальные кейсы и практические примеры: скриншоты реальных рабочих панелей, обезличенные графики аналитики или фрагменты технической документации вместо стоковых иллюстраций;
- Дата актуализации материала: четкое указание даты публикации и даты последнего обновления информации.
5. Сравнительный анализ: шаблонная SEO-статья против экспертного лонгрида
Для наглядной демонстрации разницы между устаревшим и современным подходом к созданию контента приведем сопоставительную таблицу ключевых характеристик:
Модульная система автономных капсул с микровыводами и таблицамиПлотность ключевых фразМеханическая вставка прямых вхождений (спам 3–5%)Богатый LSI-словарный запас, синонимы, отраслевой сленг и сущности (Entities)Ценность для пользователяНизкая, повторение общеизвестных фактов из ТОП-3Высокая (Information Gain), уникальные практические регламенты и цифрыРанжирование в AI / СниппетахИгнорируется или попадает под спам-фильтрыПрямое попадание в Featured Snippets и блоки ответов нейросетей
| Параметр контента | Шаблонная SEO-статья (Устаревший подход) | Капсульный экспертный лонгрид (Современный стандарт) |
|---|---|---|
| Цель создания | Занять позицию по ключевому слову любой ценой | Решить прикладную проблему целевого читателя и конвертировать его в лид |
| Структура подачи | Линейное сплошное текстовое полотно («простыня текста») | |
Инвестиции в глубокую структуризацию окупаются кратным ростом времени на странице и конверсией в целевые коммерческие действия.
6. Семантическое микроформатирование: Schema.org и сущности
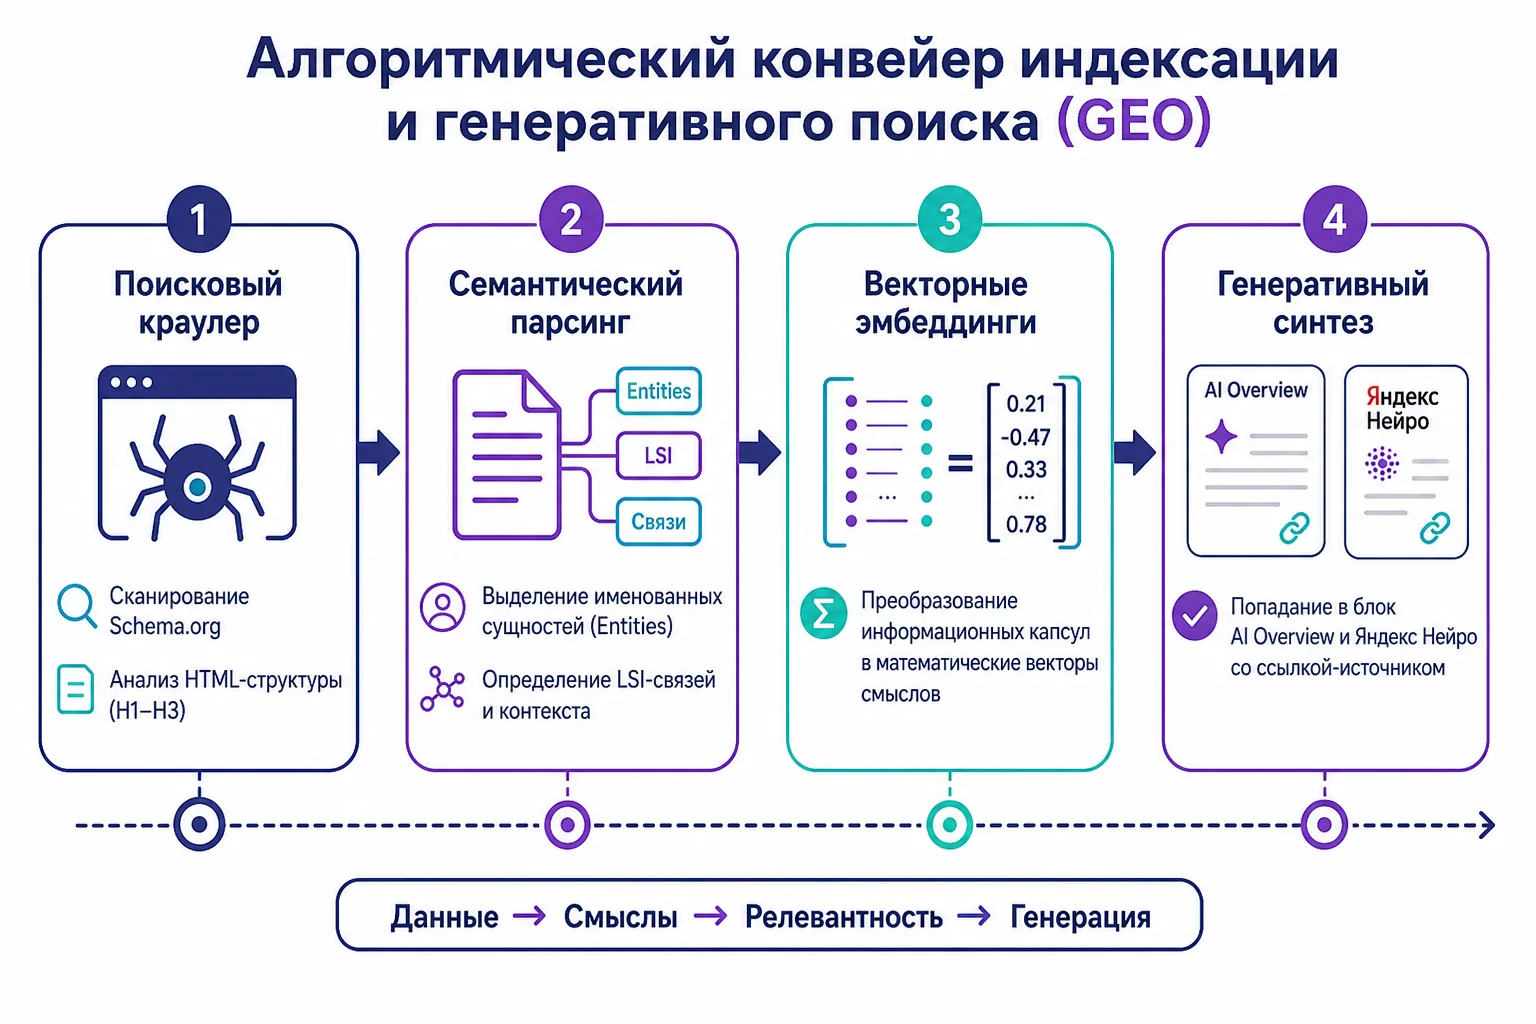
Человек воспринимает визуальную структуру статьи, однако для роботов критически важна машиночитаемая разметка. Без семантической микроразметки поисковая машина вынуждена полагаться на эвристические алгоритмы распознавания текста, что снижает точность индексации.
Обязательный программный стек микроформатирования для экспертного лонгрида включает:
- Schema.org Article / TechArticle: размечает заголовок, автора, издателя, дату создания, дату модификации и заглавную иллюстрацию. Позволяет роботу корректно идентифицировать первоисточник;
- Schema.org BreadcrumbList: передает поисковому роботу навигационную цепочку «Главная → Услуги → Контент-маркетинг», выводя аккуратные хлебные крошки в сниппете;
- Schema.org FAQPage: преобразует раздел ответов на частые вопросы в раскрывающиеся аккордеоны прямо в результатах поисковой выдачи Google, существенно увеличивая CTR сниппета;
- Open Graph и Twitter Card: мета-теги для формирования корректных карточек предпросмотра при дистрибуции материала в мессенджерах и социальных сетях.
7. Визуализация и инфографика как поисковый фактор ранжирования
Текстовый контент, не разбавленный графическими акцентами, воспринимается современным пользователем как непреодолимый барьер. Отсутствие визуальных опор провоцирует высокий процент отказов (Bounce Rate).
Графика в профессиональном лонгриде выполняет строгие прикладные функции:
- Сжатие сложной информации: одна блок-схема процесса заменяет пять абзацев технического описания, экономя время читателя;
- Рост времени сессии (Dwell Time): изучение инфографики и сравнительных таблиц задерживает пользователя на странице на 1.5–3 минуты дольше среднего значения по сайту;
- Поиск по картинкам как источник трафика: оптимизированные изображения в формате WebP с заполненными атрибутами
altиtitleстабильно привлекают дополнительный целевой трафик из Google Images и Яндекс Картинки; - Вирусный ссылочный потенциал: качественные оригинальные схемы цитируются другими вебмастерами, генерируя естественные обратные ссылки на сайт-первоисточник.
8. Адаптация под Generative Engine Optimization (GEO): как попасть в ответы нейросетей
С развитием поисковых генеративных механизмов (Google AI Overviews, Яндекс Нейро, ChatGPT Search, Perplexity) модель потребления информации кардинально меняется. Пользователь все чаще получает готовый синтезированный ответ в интерфейсе поиска, не совершая клика по традиционным ссылкам выдачи.
Чтобы сайт цитировался нейросетями в качестве авторитетного первоисточника (GEO-оптимизация), контент готовится по специальным правилам:
- Формулировки в стиле определений: четкие конструкции вида «[Термин] — это [сущность], которая решает [задачу] с помощью [инструмента]». Большие языковые модели обучены извлекать такие лаконичные дефиниции;
- Структурированные числовые списки: нейросети охотно используют списки требований, этапов и характеристик для построения своих итоговых блоков;
- Уникальные цитаты экспертов: персонализированное профессиональное мнение («по данным аудитов нашей компании в 2026 году…») маркируется моделями как ценный первоисточник;
- Высокая авторитетность домена (Domain Authority): ИИ-агенты обращаются за фактами только к тем ресурсам, которые обладают подтвержденным внешним ссылочным профилем и трастом в своей тематике.
9. Чек-лист предпубликационного аудита статьи перед релизом
Перед загрузкой материала на сайт и передачей в индекс поисковых систем редакция обязана провести сквозную верификацию параметров качества:
| Контрольная точка | Критерий соответствия | Инструмент проверки |
|---|---|---|
| Метатеги и заголовки | Title, H1 и обложка имеют уникальные формулировки без дублей | SEO-панель CMS / Screaming Frog |
| Модульность капсул | Каждый раздел H2 содержит прямой ответ в первом предложении | Редакторский фактчекинг |
| Оригинальная графика | Минимум 2–3 инфографические схемы в WebP с alt-атрибутами | DevTools / Проверка медиабиблиотеки |
| Факторы E-E-A-T | Присутствует плашка автора, ссылки на источники и дата обновления | Визуальный аудит страницы |
| Микроразметка | Отсутствие ошибок валидации в схемах Article и FAQPage | Google Rich Results Test / Валидатор Яндекса |
| Внутренняя перелинковка | Контекстные ссылки на целевые коммерческие посадочные хабы | HTML-валидатор |
Заключение: экспертный контент как долгосрочный нематериальный актив
Создание качественного экспертного лонгрида — это трудоемкий инженерный процесс, требующий глубокого погружения в специфику бизнеса и алгоритмы поисковых машин. Однако именно такой подход формирует вокруг компании устойчивый ореол отраслевого лидера.
В отличие от платной контекстной рекламы, которая прекращает давать переходы в момент обнуления рекламного баланса, структурированный экспертный контент работает по накопительной модели. Однажды опубликованная авторитетная статья собирает органический поисковый трафик, генерирует квалифицированные лиды и попадает в ответы нейросетей годами, обеспечивая бизнесу минимальную стоимость привлечения клиентов на длинной дистанции.
Микроразметка, иерархия подзаголовков, инфографика и сущности Schema.org: правила подготовки статей, которые ранжируются на первых позициях.
